8GB 노트북에서 35B를 39.3 tok/s로 돌리는 엣지 MoE 서빙 시스템 FreeToken 정리
로컬 컴퓨터에서 오픈소스 대형 언어 모델(LLM)을 돌려보면 누구나 깊은 답답함을 느끼는 순간이 있다. 바로 VRAM(그래픽 메모리) 부족이다.
모델 가중치가 그래픽카드 메모리에 다 들어가지 않으면 어쩔 수 없이 시스템 메모리(RAM)로 넘겨서 돌려야 하는데, 이 순간부터 추론 속도가 초당 1~3토큰 수준으로 곤두박질친다.
특히 요즘 최고의 가성비와 성능을 보여주는 모델들은 대부분 MoE(Mixture-of-Experts, 전문가 혼합) 구조를 쓴다. 전체 크기는 수백 기가바이트(200B~700B)에 달하지만 매 순간 필요한 전문가는 일부(수십 기가바이트)뿐이라 로컬 구동에 최적일 것 같지만, 기존의 도구들로는 여전히 실시간 대화가 불가능할 정도로 느렸다.
UC Berkeley, MIT 등의 연구진이 최근 공개한 오픈소스 서빙 시스템 《FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution》 [1]은 이 난제를 완전히 새로운 관점으로 풀어낸다.
개인용 컴퓨터를 “데이터센터 GPU의 축소판(작은 GPU)“으로 다루지 말고, GPU·CPU·RAM·저장장치를 하나의 탄력적인 연산 플랫폼으로 묶어 다루자는 것이다.
어떻게 8GB VRAM 노트북에서 35B MoE 모델을 초당 40토큰으로 뽑아내고, 단일 데스크톱에서 284B 초거대 모델을 실시간 서빙할 수 있는지 그 아키텍처를 알기 쉽게 정리했다.
1. 문제의 본질: 연산이 아니라 ’PCIe 데이터 배달’이 막힌다
컴퓨터에서 대형 언어 모델을 돌릴 때 속도를 좌우하는 병목은 생각보다 단순하다.
| 하드웨어 장치 | 주요 역할 및 특징 | 물리적 한계 및 병목 |
|---|---|---|
| GPU (VRAM 8~24GB) | 초고속 행렬 연산 담당 | VRAM 용량이 좁아 거대 모델 적재 불가 |
| CPU + RAM (32~128GB) | 넉넉한 모델 가중치 보관소 | GPU 대비 연산 및 데이터 처리 속도 저속 |
| PCIe 버스 통로 (16~32 GB/s) | RAM에서 GPU로 가중치를 나르는 통로 | 초당 전송 대역폭의 한계로 극심한 I/O 병목 유발 |
개인용 PC는 GPU VRAM이 8GB~24GB 수준으로 좁은 대신, 시스템 RAM은 32GB~128GB로 넉넉하다. 그래서 기존 도구들(Ollama, llama.cpp, KTransformers 등)은 초과하는 모델 가중치를 RAM에 두고 필요할 때마다 PCIe 통로로 퍼 올려 쓰는 오프로딩(Offloading) 기법을 수행한다.
하지만 이 방식에는 치명적인 병목이 있다.
- PCIe 대역폭 병목: GPU 연산 코어는 0.001초 만에 계산을 끝낼 준비가 되어 있는데, 좁은 PCIe 도로를 통해 가중치가 올라오는 것을 기다리느라 대부분의 시간을 멍하니 놀며 보낸다(I/O Bound).
- 정적 분할의 비효율: “레이어 1~10은 GPU, 11~30은 CPU”처럼 고정해 두면, 특정 레이어의 전문가가 쓰이지 않아도 귀중한 GPU 메모리를 계속 낭비하게 된다.
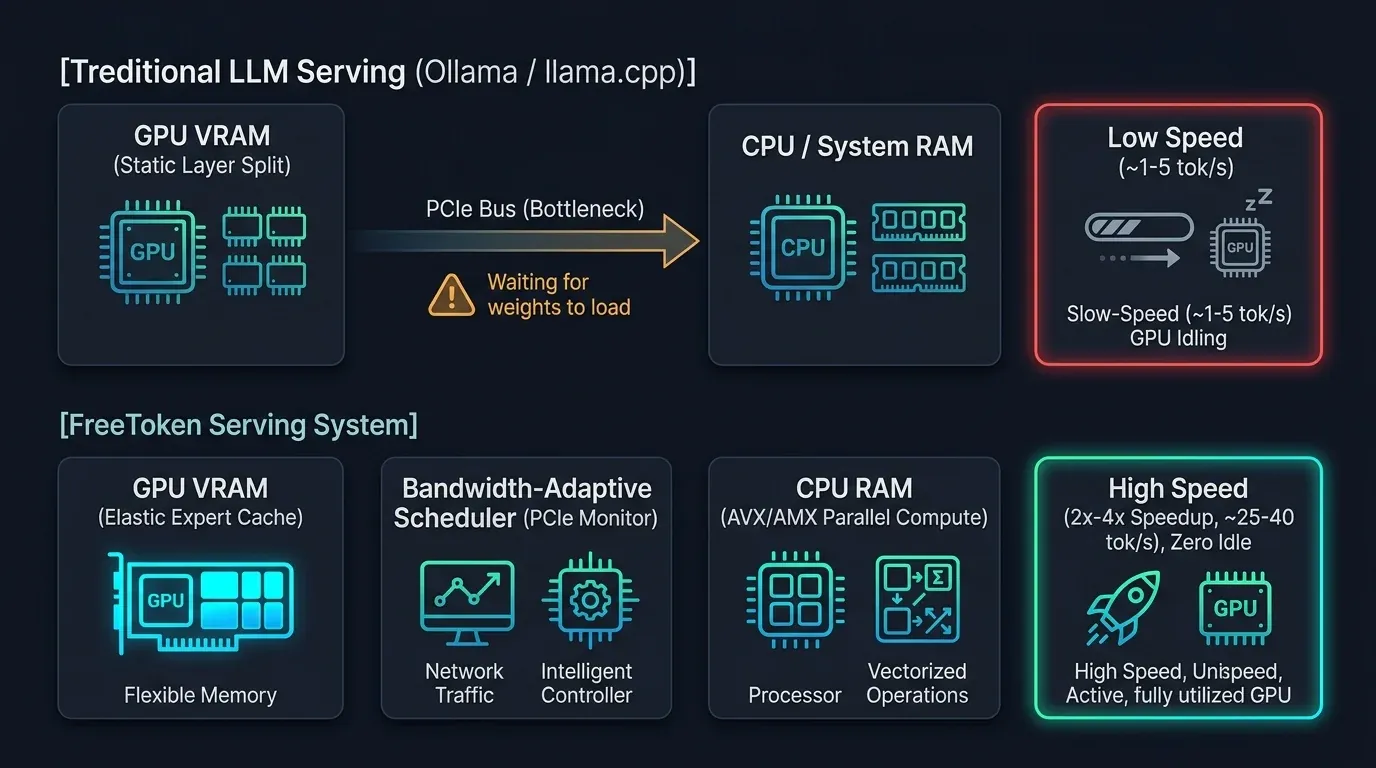
2. FreeToken의 철학: PC 전체를 하나의 탄력적 플랫폼으로
FreeToken의 핵심 철학은 명확하다.
“개인용 컴퓨터를 ’VRAM이 작은 GPU’로 보지 말고, GPU와 CPU, RAM, 저장장치가 어우러진 ’하나의 탄력적 추론 플랫폼’으로 다루자.”
특정 하드웨어에 고정된 역할을 강제하지 않고, 실시간 런타임 대역폭과 연산 부하에 맞춰 연산과 메모리를 유연하게 동적 재배치한다.
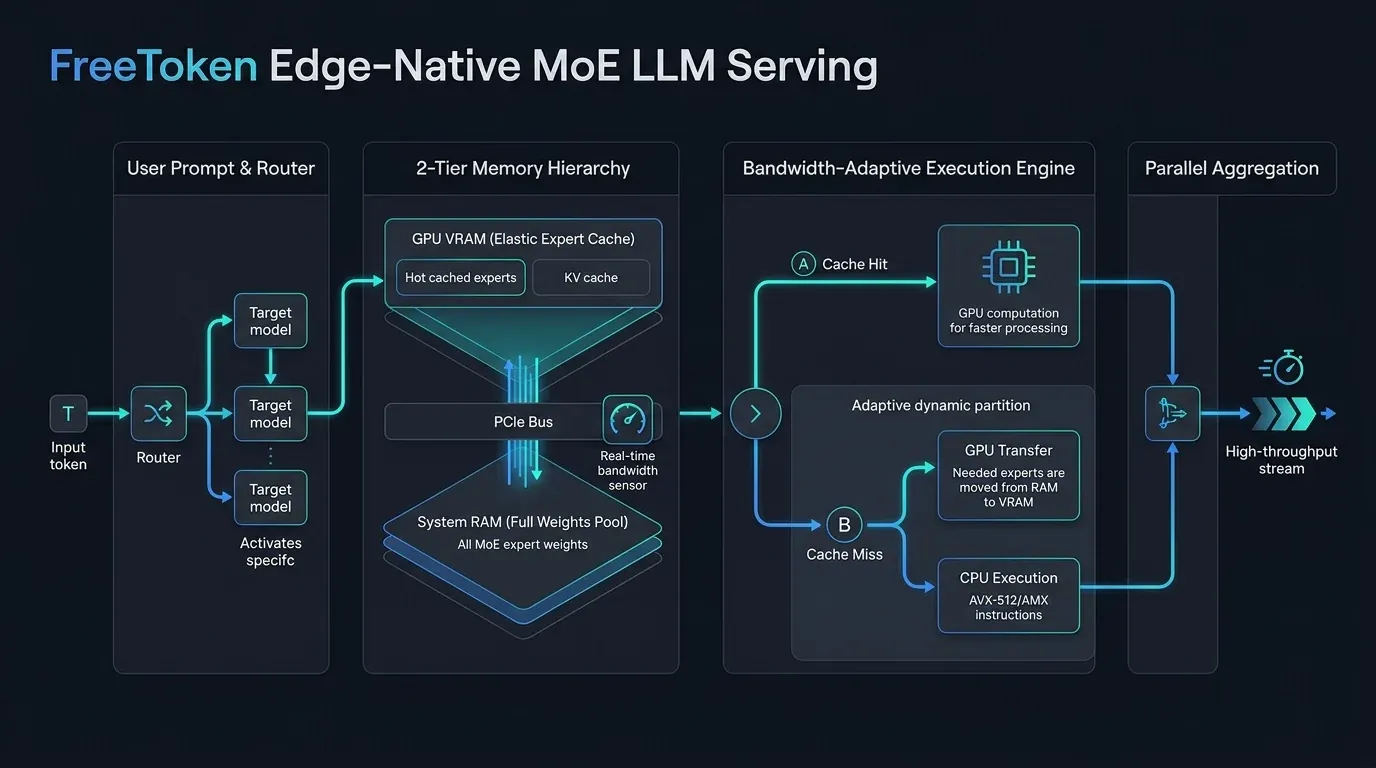
3. FreeToken의 3대 핵심 아키텍처
| 핵심 아키텍처 | 담당 기능 | 세부 메커니즘 |
|---|---|---|
| 1. 탄력적 VRAM 캐시 (Elastic Expert Cache) |
레이어 구분 없는 통합 캐시 풀 | 가장 최근에 호출된 전문가가 레이어 구분 없이 VRAM에 남고, 가장 오래 안 불린 전문가가 밀려남(LRU) |
| 2. 대역폭 적응형 실행 (Bandwidth-Adaptive) |
미스를 두 경로로 분할해 동시 실행 | 기계별 실측 대역폭 비(B_P : B_H)로 미스를 GPU 전송분과 CPU 실행분으로 나눠 병렬 처리 |
| 3. 에이전트 상태 재사용 (State Reuse Engine) |
반복 작업 KV 캐시 재사용 | 도구 호출 시 공통 프롬프트 캐시 유지 및 의미 경계에 순환 상태 체크포인트 고정 |
1) 레이어 구분을 없앤 ‘탄력적 VRAM 캐시’
VRAM을 특정 레이어별로 쪼개서 잠가두지 않는다. 모델의 기본 뼈대(어텐션 레이어)를 올리고 남은 모든 VRAM을 하나의 거대한 통합 전문가 캐시로 선언한다. 전문가 가중치 전체는 언제나 시스템 RAM에 남아 있고(진실의 원천), VRAM에는 최근에 쓰인 전문가의 사본만 올라간다. 연속된 토큰이 같은 레이어에서 겹치는 전문가로 자주 라우팅되는 시간적 국소성을 LRU 캐시로 그대로 받아낸다. 로드 시점에 인기 전문가를 고정해 두는 방식과는 다르다.
2) 대역폭 적응형 실행 (Bandwidth-Adaptive Execution)
전문가가 VRAM 캐시에 없을 때, 무조건 GPU로 올리려 고집하지 않는다.
- 배포 시점에 그 기계에서 두 값을 한 번 실측해 둔다. PCIe 전문가 전송 대역폭(B_P)과 CPU 쪽 전문가 커널의 실효 대역폭(B_H)이다. 런타임에 바뀌는 것은 대역폭이 아니라 캐시 미스 개수 m뿐이다.
- 미스가 m개 나오면 둘 중 하나를 고르는 게 아니라 m개를 비율대로 쪼갠다. B_P 몫은 PCIe로 실어 올려 GPU가 계산하고 캐시에 남기며, 나머지는 RAM에 있는 그대로 CPU가 계산한다. 두 갈래는 동시에 돈다. PCIe 전송이 먹고 남긴 잔여 호스트 메모리 대역폭이 곧 CPU 몫이기 때문이다.
- 어느 한쪽 장치도 놀거나 멈추지 않고 100% 풀가동되는 완벽한 밸런싱을 달성한다.
3) 에이전트 워크로드 맞춤 상태 재사용
AI 에이전트가 코딩이나 파일 검색 같은 도구 호출(Tool use)을 반복할 때, 매 턴마다 반복되는 시스템 프롬프트의 KV 캐시를 효율적으로 재사용한다. 에이전트 하네스는 매 턴 thinking 블록이나 오래된 도구 출력을 잘라낸다. 이때 잘린 지점 뒤의 순환 상태 체크포인트는 전부 무효가 되어, 수천 토큰을 다시 프리필해야 한다. FreeToken은 체크포인트를 이런 의미 경계(semantic boundary)에 미리 박아둔다. 하네스가 편집해도 그 앞의 접두부는 그대로 보존되므로 체크포인트가 살아남을 확률이 훨씬 높고, 새로 늘어난 뒷부분만 다시 계산하면 된다.
[개념 짚고 가기: KV 캐시(KV Cache)란?]
LLM이 대화를 나눌 때 이전 문맥을 매번 처음부터 다시 계산하지 않도록, 이미 계산해 둔 중간 연산 결과(Key, Value 벡터)를 메모리에 임시로 적어두는 저장 공간입니다. 대화가 길어질수록 이 캐시가 VRAM을 많이 차지하므로, 이를 똑똑하게 재사용하는 것이 로컬 구동의 핵심입니다.
4. 기존 서빙 엔진 vs FreeToken 성능 비교
| 기기 환경 | 탑재 모델 | FreeToken 속도 | 체감 수준 |
|---|---|---|---|
| 8GB 노트북 (RTX 4060) | Qwen3.6-35B-MoE | ~39.3 tok/s | 일반 대화 및 코딩 보조가 매우 쾌적한 속도 |
| 게이밍 PC (RTX 5090 32GB) | DeepSeek-V4-Flash (284B) | 22~25 tok/s | 284B 초거대 모델을 실시간 인터랙티브로 구동 |
| 단일 워크스테이션 (RTX PRO 6000) | GLM-5.2 (753B) | ~14.9 tok/s | 753B 프론티어급 모델을 단일 GPU 시스템에서 서빙 |
[ 기존 대표 엔진 대비 처리량(Throughput) 개선 ]
• 최강 베이스라인 대비 : 모든 워크로드에서 디코드 처리량 1.5~2.3배
  (비교 대상: llama.cpp, Ollama, KTransformers, MoE-Infinity)
• llama.cpp 대비    : GLM-5.2(753B)를 RTX PRO 6000 한 장에서
                     14.9 tok/s vs 7.3 tok/s로 2.0배 (동일 비트 가중치)
• KTransformers 대비: 최악 턴 TTFT 946초 vs FreeToken 44초 미만.
                     단 평균 TTFT는 일부 셀에서 KTransformers가 앞선다
• RTX 5090 실측    : Qwen3.6-35B-A3B 77~83 tok/s
                     DeepSeek-V4-Flash 22~25 tok/s
• 단, Ollama와 MoE-Infinity는 DeepSeek-V4-Flash를 아예 서빙하지 못한다
5. 실전 설치 및 로컬 에이전트 연동 가이드
논문은 코드를 github.com/FlashML-org/FreeToken에, 배포본을 flashml.ai에 공개했다고 밝힌다.
주의할 점이 하나 있다. 논문이 기술한 에이전트 연동 경로는 OpenAI 호환이 아니라 Anthropic 호환 엔드포인트다. 실험(W3 워크로드)에서도 Claude Code를 각 엔진의 Anthropic 호환 엔드포인트에 물렸다.
구체적인 설치 명령과 포트 규격은 논문에 없으므로 저장소 문서를 따르는 편이 정확하다.
6. 엔지니어링 시사점: 모델을 깎는 대신 컴퓨터를 엮다
그동안 로컬 LLM 생태계의 주된 패러다임은 “어떻게든 모델을 4비트, 2비트로 깎아서(양자화) 작은 GPU 안에 우겨넣을까”라는 고민에 집중되어 있었다. 하지만 이 과정에서 모델 본래의 추론 능력과 지능 손실을 피할 수 없었다.
FreeToken이 보여준 패러다임 전환은 신선하다. 모델을 억지로 깎아내는 대신, 내 컴퓨터 안에 이미 꽂혀 있는 고성능 CPU, 넉넉한 RAM, 초고속 NVMe를 소프트웨어적으로 어떻게 하나의 유기적 팀으로 엮을 것인가를 고민했다.
Spark, Ray, vLLM을 만든 분산 시스템의 석학들(Ion Stoica, Matei Zaharia)과 하드웨어 가속 권위자(Song Han)가 협력하여, 수천 대의 서버를 엮던 분산 스케줄링의 지혜를 개인용 데스크톱 내부로 가져온 인상적인 성과다.
참고 문헌 및 원문
- [1] Yang S, Fan X, Pan M, et al. FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution. arXiv:2608.16157, 2026. (arXiv 원문 · GitHub 저장소 · 웹사이트)